复盘一次 gulp & webpack 构建优化

接续前一篇《并行化密集型计算》,发现实际上线时 parallel terser 并没有提升速度。反而比单线程还要慢,这就有点不科学了。首先想本地跑起来没有出错,大概不是程序逻辑问题,再想想看,估计是配置问题,与 SA 进行了一波有力的交流。
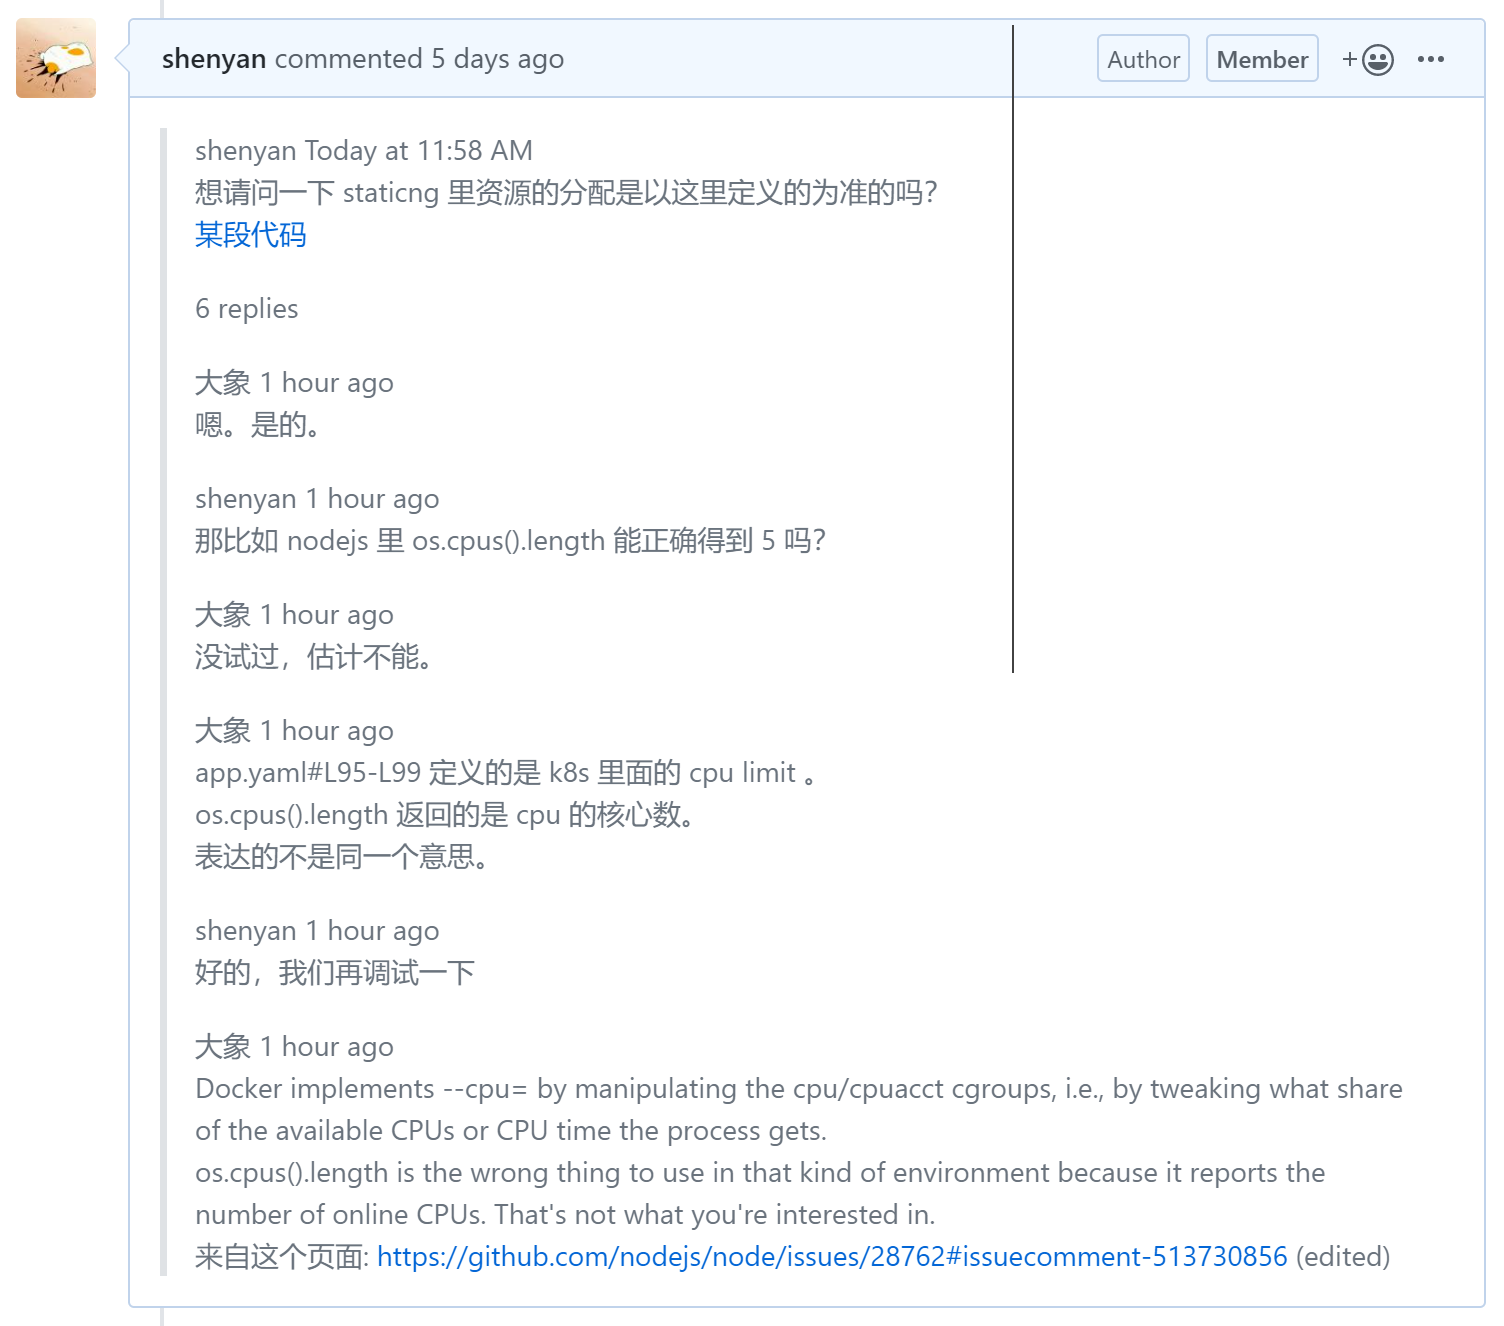
有力的交流过程

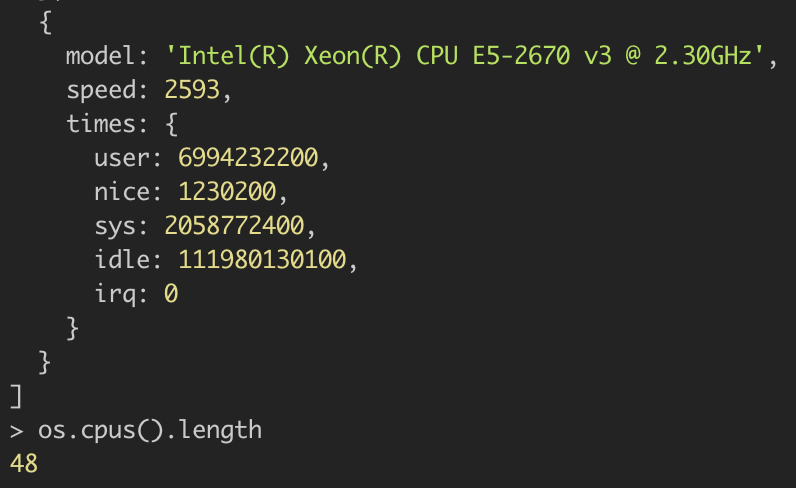
原来 os.cpus() 拿到的是真实的计算机 CPU 核数,而 k8s 会限制容器的 CPU 使用量,所以我们应该手动将 NODE_ENV=production 时的并发数限制在 5 以内。

进一步思考这种 utility 和 business 代码混写在一起的方式极其耦合,想要更高效地发挥代码的作用必须分离它们,于是就借鉴了 terser-webpack-plugin 中对于 jest-worker 的应用改了一下,并将其应用于 webpack 的打包,取得了不错的效果。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
gulp.task('webpack', function() {
const { result$, next, end } = parallelRunner(
__filename,
function(worker, configName) {
return Promise.resolve(
worker.compile(
null,
[configName]
)
)
},
isProduction ? PRODUCTION_PARALLEL_NUMBER : true
)
Object.keys(configNameToFileMap).forEach((name) => next(name))
end()
return result$
})

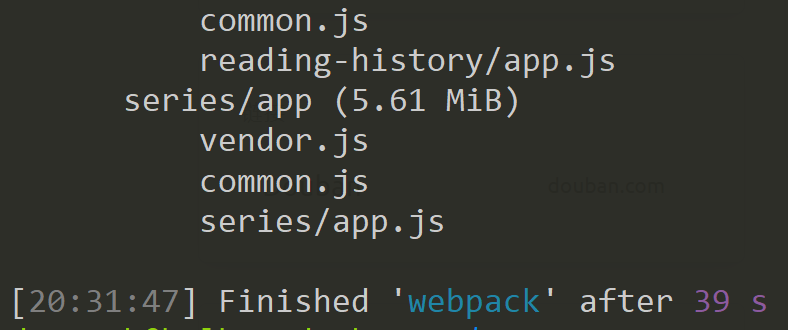
webpack 打包跑进了 40 秒大关

但实际到了线上 webpack 依然花了将近 4 分钟,与此同时 gulp parallel terser 已经稳定在 1 分钟之内了。这时一段异常的日志引起了我的注意。
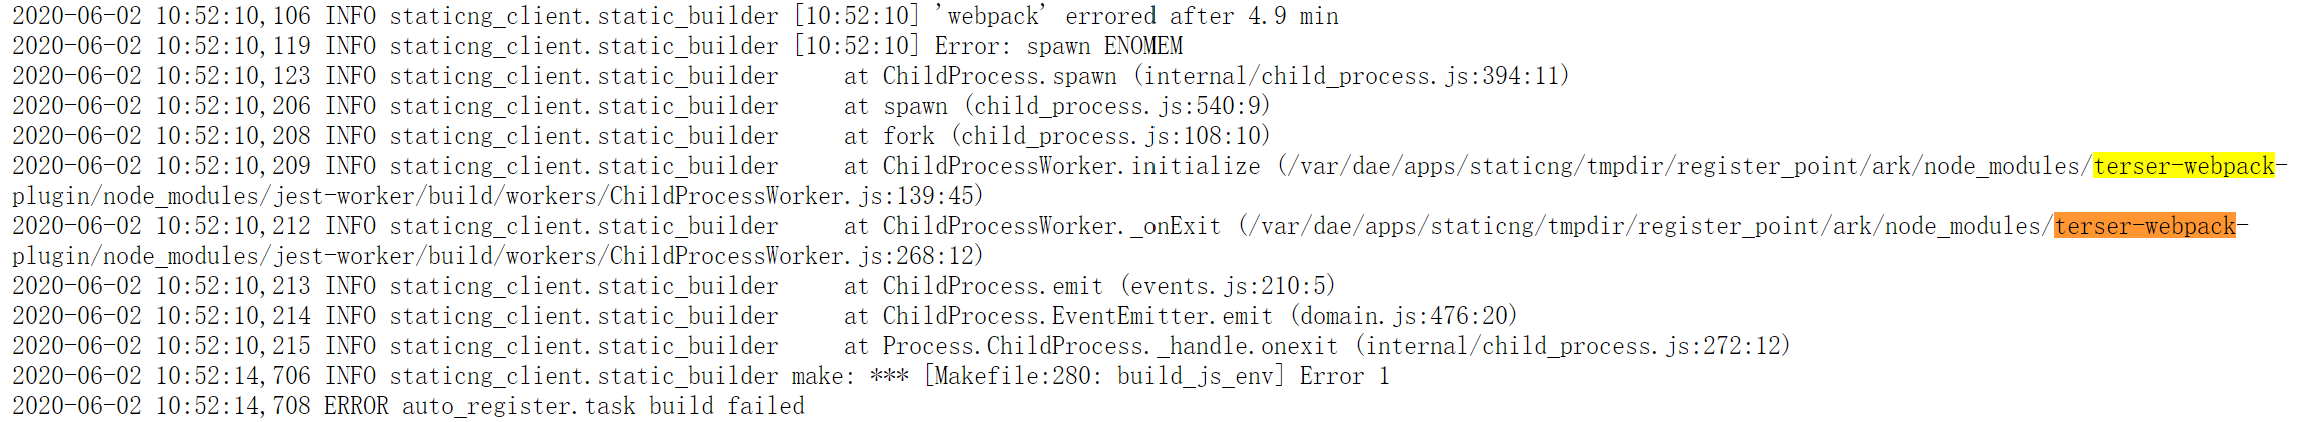
terser-webpack-plugin 并发出错

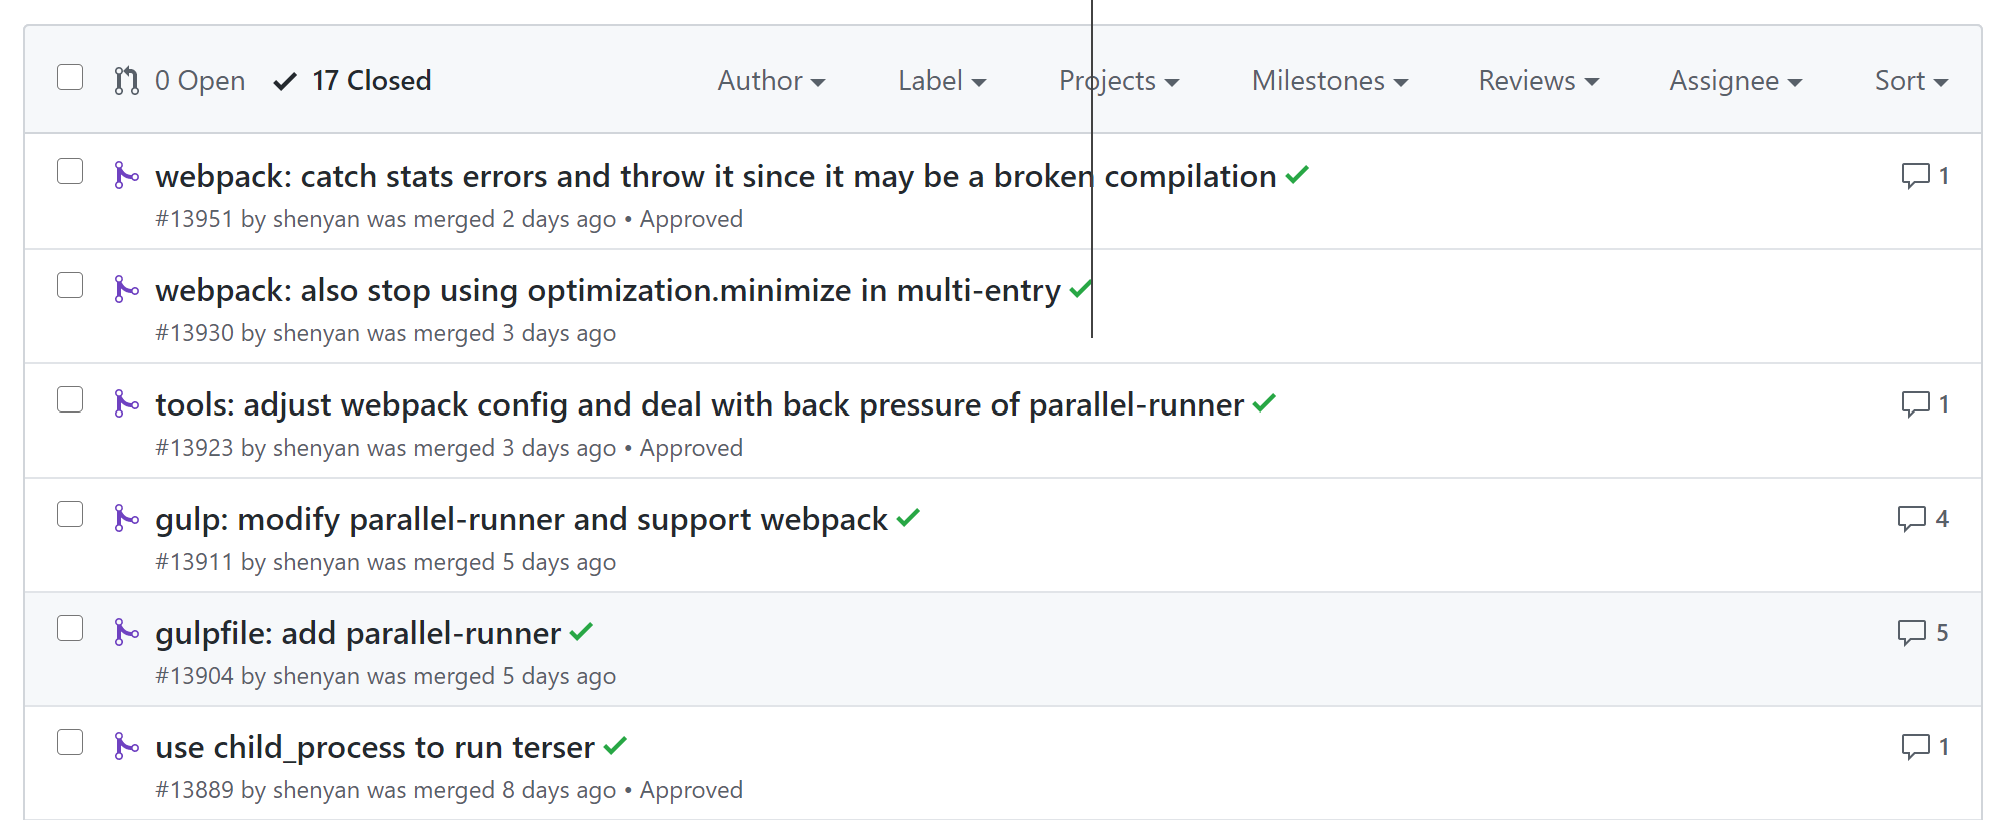
原来 webpack 里自带的 terser-webpack-plugin 会在 production mode 下自动开启,又是 48 线程 …… 4 * 48 = 192 线程,OMG,不跑崩让 SA 来请喝茶才怪了。但转念一想,好像后面我们还会对各种文件都 terser 一遍,在 webpack 里压缩似乎是没有必要的?于是乎直接禁用 optimization.minimize 就可以了。

期间又优化了一下 parallel-runner,处理了一下 stream/rxjs observable/worker 之间的 back pressure 问题。简单说就是当 rxjs mergeMap 把一个值传到 worker 里去处理时才算作 consumed,会继续向上游 pull 下一个数据,这样就把上下游的数据链接给建立起来了,而不是之前那样全部 pull 下来堆在 mergeMap 外面,容易形成 memory leak。

Call the callback function only when the current file (stream/buffer) is completely consumed.

parallel-runner 把 data(vinyl File) 放到 worker 去处理标志该数据为 consumed(实际结果会在 result$ 里被 push 给下游的 writable stream),然后 stream 会根据是否 end 或者到达 highWaterMark 自动去 read(pull) 上游 readable stream 的下一个数据,也就是执行我们传入的 transform 方法。数据可能堆积在 mergeMap 外最多一个,因为那个数据不进入 mergeMap 就不会继续触发 consumed,之前是一口气全 read。

最后,规范化了一下 webpack 出错时向 main process 通报错误的方法,该出错就出错,不要静默失败到上线时出大问题。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
return new Promise((resolve, reject) => {
webpack(configs, function(error, stats) {
let errors
if (stats) {
log(stats.toString(Object.assign({
// https://webpack.js.org/configuration/stats/
chunks: false,
colors: colors.supportsColor,
}, configs[0].stats)))
}

if (error || stats.hasErrors()) {
// errors should be serializable since it will go through processes
errors = error ? error.toString() : stats.toJson().errors
}

if (callback) {
callback(errors)
}
if (errors) {
reject(errors)
} else {
resolve()
}
})
})

至此,这次优化 gulp & webpack 打包构建流程的优化工作就算告一段落了,实际上大概处理了以下几个问题:

  • 将重复性的任务放到多线程并行执行
  • 提取公共代码转成 utilities
  • 区分本地开发与生产环境,尊重基础设施对于计算资源的分配规则
  • 剔除多余的步骤避免重复计算(侧面说明不要替用户预先做决定的重要性)
  • 向官方推荐实现靠拢,以求符合标准融入开源库的生态环境

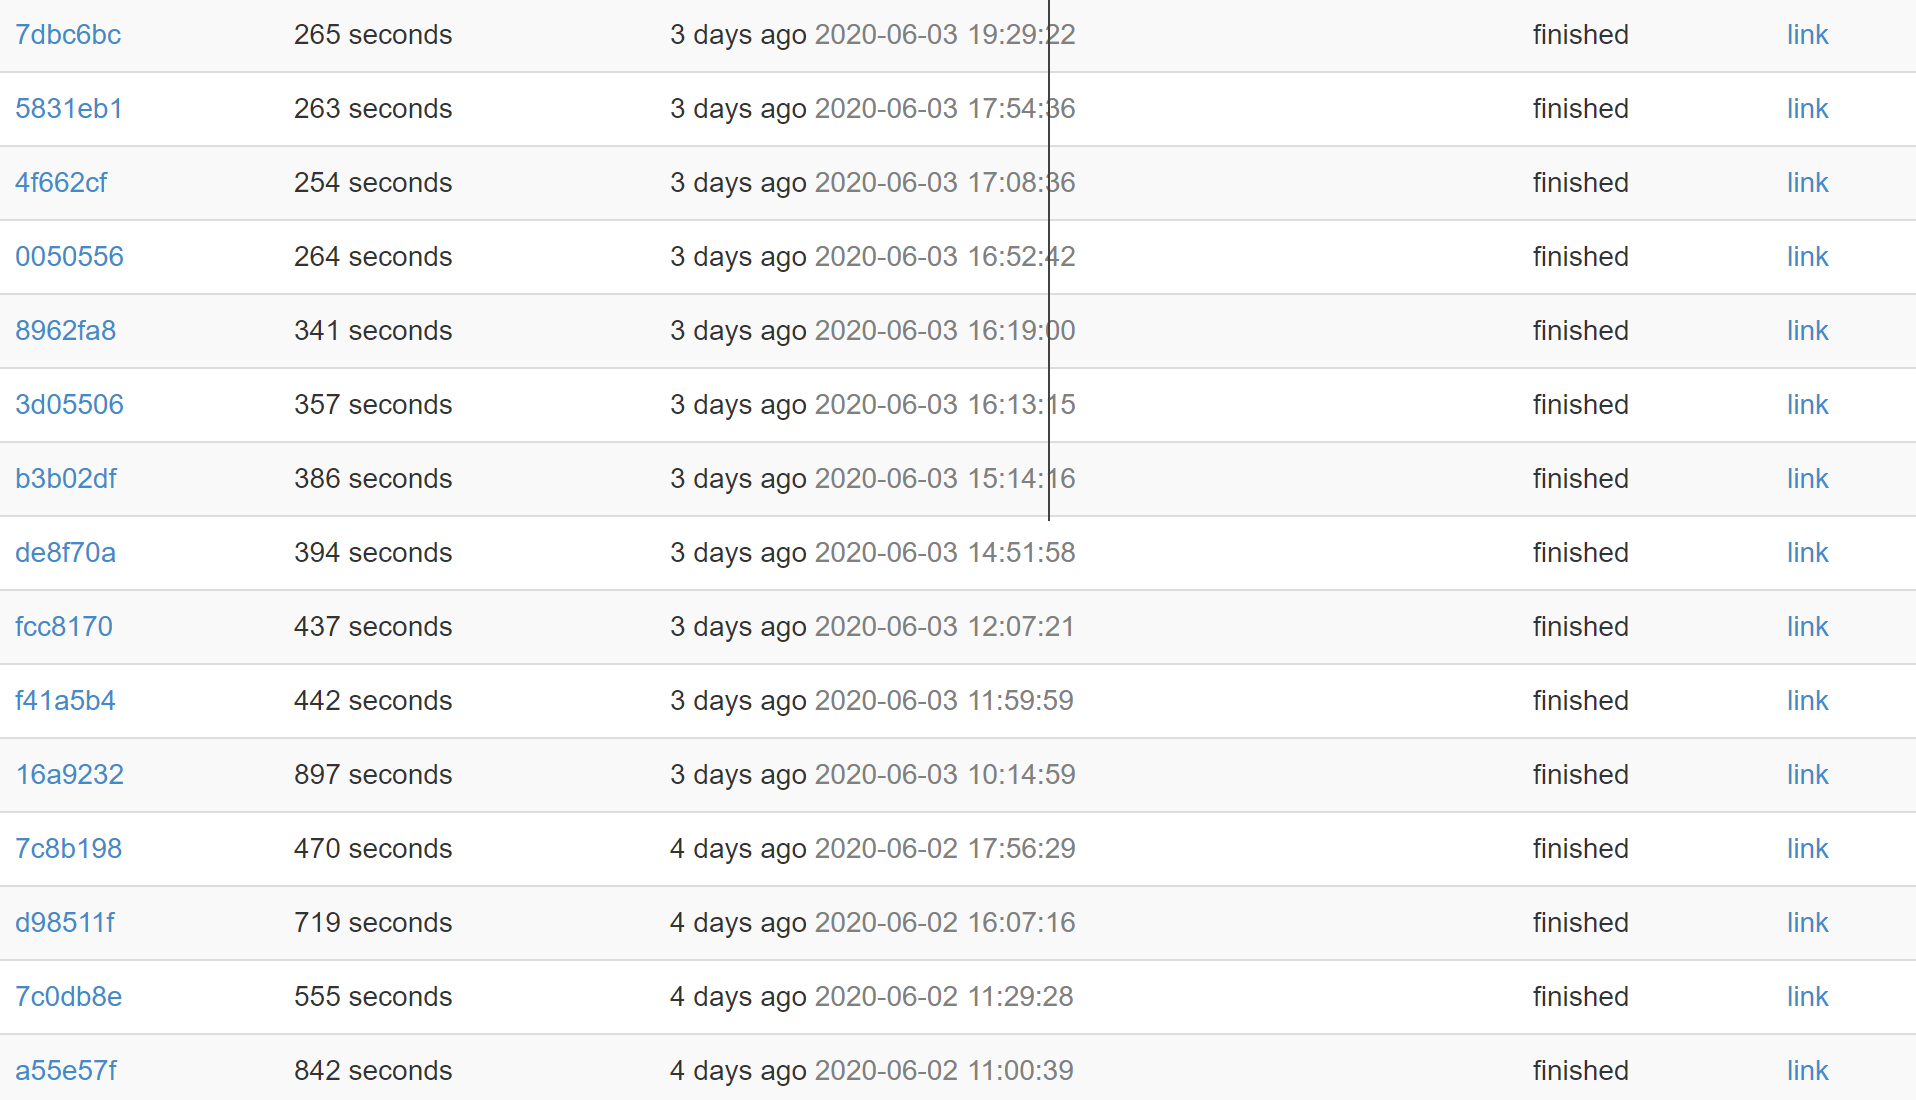
历经近一周时间,完成了优化工作

整体打包速度从 700 ~ 800s 提升到了 250 ~ 300s!

下面直接贴出了 parallel-runner 的代码,小弟手艺不佳,写得不好,各位如有需要可以在此基础上稍加改动以适应业务需要。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
// Inspired by terser-webpack-plugin.

const os = require('os')
const rx = require('rxjs')
const rxOperators = require('rxjs/operators')
const JestWorker = require('jest-worker').default
const through2 = require('through2')
const log = require('fancy-log')

const { Subject, from } = rx
const { mergeMap, share } = rxOperators

function getAvailableNumberOfCores(parallel) {
const cpus = os.cpus() || { length: 1 }

return parallel === true
? cpus.length - 1
: Math.min(Number(parallel) || 0, cpus.length - 1)
}

function parallelRunner(
module,
taskCallback,
parallel = true
) {
const availableNumberOfCores = getAvailableNumberOfCores(parallel)
let concurrency = 1 // which means mergeMap will behave as concatMap
let worker
let total = 0
let completed = 0
let allScheduled = false

log('Parallel Running: ', module)
log('Available Number of Cores: ', availableNumberOfCores)

// setup worker
if (availableNumberOfCores > 0) {
const numWorkers = availableNumberOfCores
concurrency = numWorkers
log('Number of Workers: ', numWorkers)
worker = new JestWorker(module, { numWorkers, enableWorkerThreads: true })

const workerStdout = worker.getStdout()
if (workerStdout) {
workerStdout.on('data', (chunk) => {
return process.stdout.write(chunk)
})
}

const workerStderr = worker.getStderr()

if (workerStderr) {
workerStderr.on('data', (chunk) => {
return process.stderr.write(chunk)
})
}
}

// handle concurrency with rxjs
const scheduled = new Subject()
const consumed = new Subject()

const result$ = scheduled.pipe(
mergeMap((data) => {
// data is actually consumed here
consumed.next(null)
// worker[methodName] can only be invoked with serializable data
// and returned value could be just plain RESULT or Promise<RESULT>
return from(taskCallback(worker || require(module), data))
}, concurrency),
share()
)
result$.subscribe({
complete: function() {
if (worker) {
worker.end()
}
},
next: function() {
completed += 1
if (allScheduled && completed === total) {
scheduled.complete()
}
},
error: function(err) {
throw err
}
})

return {
result$,
consumed$: consumed.asObservable(),
next: (data) => {
scheduled.next(data)
total += 1
},
complete: () => { allScheduled = true }
}
}

function gulpParallelRunner(module, taskCallback, parallel) {
const {
result$,
consumed$,
next,
complete
} = parallelRunner(module, taskCallback, parallel)
let afterComplete, stream, afterConsume

consumed$.subscribe(() => {
// `afterComplete was defined` means there is no more data
if (!afterComplete && afterConsume) {
afterConsume()
}
})

result$.subscribe({
complete: () => {
if (afterComplete) {
afterComplete()
}
},
next: (data) => {
stream.push(data)
// if returned value is false means stream ends or meets highWaterMark
// but we don't care since we use rxjs to control concurrency
}
})

const flush = function(cb) {
afterComplete = cb
complete()
}
const transform = function(file, enc, afterTransform) {
if (!stream) {
stream = this
}
if (!afterConsume) {
afterConsume = afterTransform
}
next(file)
}
return through2.obj(transform, flush)
}

// Staticng has CPU limit of 5 on k8s, so we can't use os.cpus().length which
// reports the number of online CPUs, but running with 4 threads is fast enough.
// https://github.com/nodejs/node/issues/28762#issuecomment-513730856
const PRODUCTION_PARALLEL_NUMBER = 4

module.exports = {
parallelRunner,
gulpParallelRunner,
PRODUCTION_PARALLEL_NUMBER,
}

实际应用于 terser 的代码

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
function parallelTerser(needMangle) {
const options = generateTerserOptions(needMangle)
return gulpParallelRunner(
require.resolve('terser'),
function(worker, file) {
return Promise.resolve(worker.minify({
[file.path]: file.contents.toString('utf-8')
}, options)).then((result) => {
if ('error' in result) {
throw new Error(result.error.message)
}
file.contents = 'from' in Buffer ? Buffer.from(result.code) : new Buffer(result.code)
return file
})
},
isProduction ? PRODUCTION_PARALLEL_NUMBER : true
)
}

并行化密集型计算

稍早前对 terser 压缩代码进行优化时将执行过程的代码从 Python 迁移到了 Node.js,准确地说是试图用 gulp stream 来批量压缩,用了一个比较老的包(gulp-terser),已经很久不维护了。与原先相比,底层都是 terser,只是为了在 Node.js 的镜像下使用而统一了文件的提取(glob)和批处理过程(Python Pool & subprocess -> gulp stream)。

但这样处理了以后发现压缩处理时长变长了很多,差不多慢了 1 分钟,研究了一下 gulp 的处理机制,发现虽然 gulp 号称流式处理,但文件依然是按个通过 pipe 的,前一个处理完下一个才能进入,但通过 parallel-transform 也能实现同时处理多个文件,可是实际操作中以 parallel-transform 替代 through2 并不能提升处理效率。笔者并未实际深究其原因,大致读了下 parallel-transform 的实现,它依然是围绕着 event-loop 做文章,设想成一个水池,干涸了就加水,满了就停止并等待处理完毕抬高基准线。

笔者甚至使用了 RxJS 来控制并发 …… 但事实证明还是自己太年轻了,这种密集型计算根本无法通过 event-loop 来优化,它和 ajax 或者 IO 操作不一样,处理数据的仍是这个进程,怎么办?那就多进程/多线程!

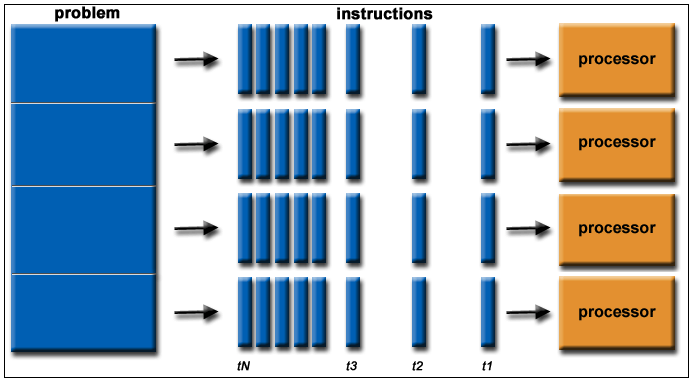
问题就变得简单了起来,第一步把文件列表拿到,第二步把它们分发到其他进程/线程处理。

首先想到的是 gulp.src 接受的是数组,而 glob 接收的是字符串,实现肯定不一样,事实证明果然相差甚远。想想看还是需要先拿到本着能不造轮子就不造轮子的思路,去网上搜搜代码,首先想到的是已废弃的 gulp-util。一看里面有个 buffer 符合我们的需要,直接抄来,只不过需要注意一下这里有个 cb 需要塞到 fn 的回调里去,这样才能准确得到 task 的总共执行时间。

1
2
3
4
5
6
7
8
9
var end = function(cb) {
this.push(buf);
--- cb();
--- if(fn) {fn(null, buf);
+++ if (fn) {
+++ fn(null, buf).then(cb)
+++ }
}
};

fn 是个耗时的操作,必须再它完成后再 cb

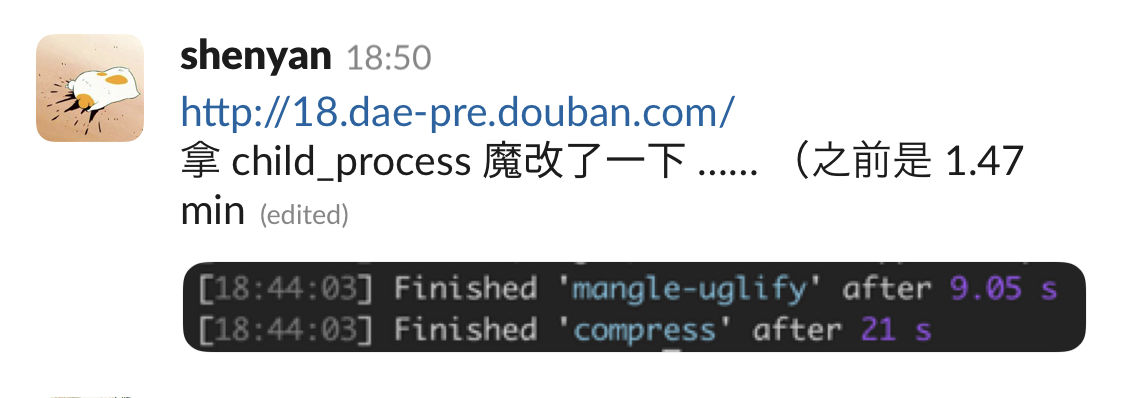
然后按照 terser 和 child_process 的关键词找到了 @bazel/rules_nodejs - terser 这个包,简直是宝藏 …… 一顿大抄特抄,写死了 terser 执行参数,加了个 Promise 的返回值。上 pre 跑了一下,功德圆满!

快了整整 4.5 倍!

为啥这么快?看了下 CPU 数量,我惊呆了!

48 核???

顺便看了下 issue 里也有试图引入 works_thread,不过 child_process 已经足够香了!

不过 web 上毕竟一个 page 只有一个进程,所以要有 Web Worker 来让密集计算在主线程之外运行,而可预计到的是 Web Worker 和 work_thread 的关系就好比 wasm 和 wasi,激动人心的进展!

并行计算大势所趋

程序员应该写出怎样的代码

虽说老板和产品经理都不会太关心代码质量,所求无非是美观可用效率高等等,但作为一个略有追求的程序员在严酷的需求排期和反复推翻修改的生存环境之下,面对前人挖下的坑和自己几个月前寥寥草草写出的 adhoc 代码,总会望洋兴叹一番,痛定思痛想要写出一些拯救苍生(几个月后的自己)的传世代码。

然鹅面对一堆静态动态模板混杂、数个参数可变返回数据可变的异步嵌套接口加上鬼都不认识的 model/view 继承堆积起来意大利面条一般的代码,更别说还有不知哪里引用的全局样式给兴高采烈调完所有组件的你温柔一刀。怎么办?

首先从简单的样式部分着手,CSS Module 或 styled component 完美解决了局部样式的问题,SSR 解决了前后端模板的一致性。这些都是社区提供的通用方案,剩下的基本就是如何组织 model 以及接口了,即前后端数据同步问题。

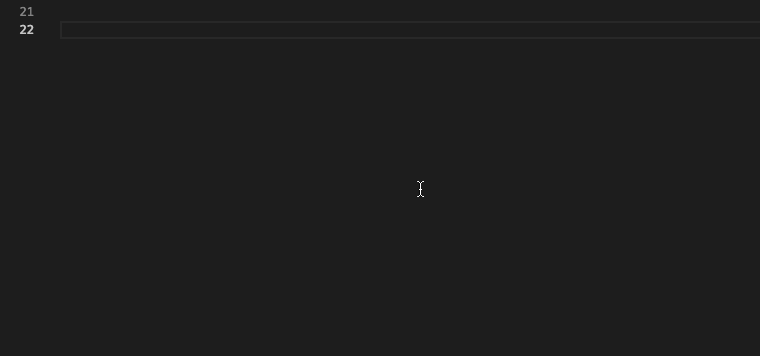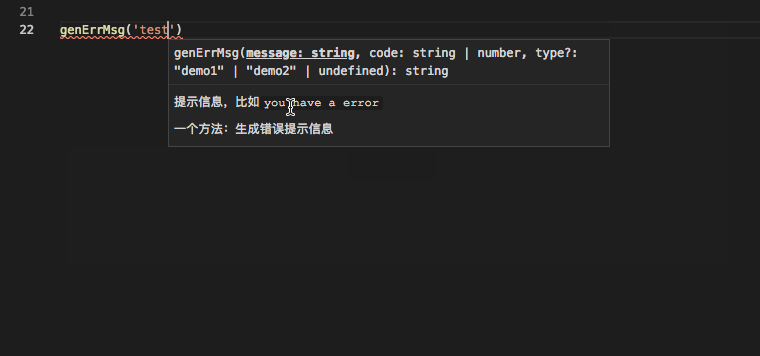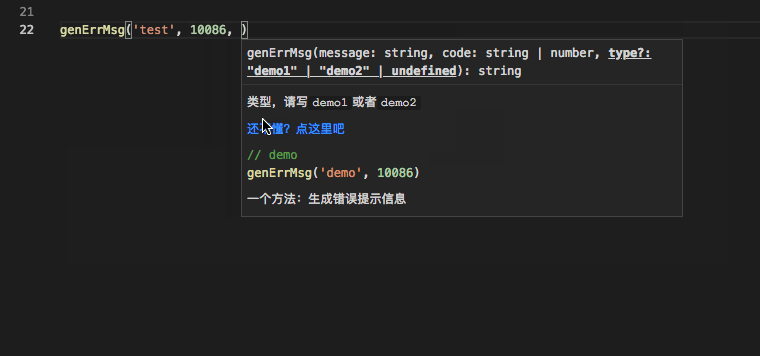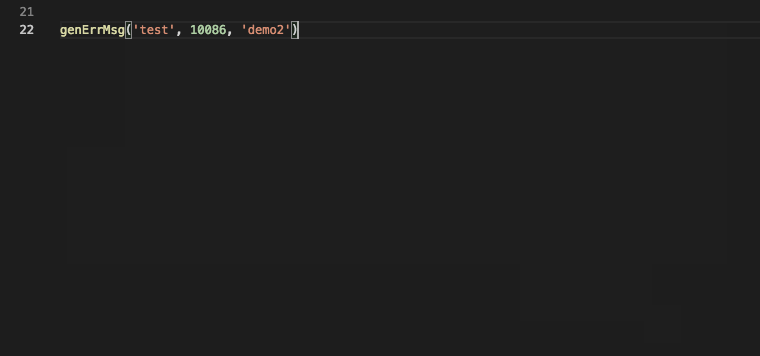
我们知道 Python 和 JavaScript 都是动态语言,而动态语言最臭名昭著的就是“动态一时爽,重构火葬场”,基本一个数据倒上那么三四次手之后就变得亲妈不认了。类型是一定要加的,我们用 TypeScript!

https://juejin.im/post/5d8efeace51d45782b0c1bd6

具体的好处前面已经提到过了,这里想说明的是类型定义不仅保证了代码逻辑的正确性,也给予阅读时良好的体验,有了类型以后相当一部分关于变量的说明都可以挪到 type 和 interface 上,代码更容易实现“自解释”。其实 ES Module 很大程度上已经完善了代码的引用逻辑,但相比之下类型定义具有更强的约束(字段级别)和更灵活的配置(interface 鸭子类型),所以都 0202 年了,还不上 TypeScript 真的都没法说自己是工程化的前端项目。

但 TypeScript 只是解决了前端的代码一致性,JavaScript 总还是要在 web 这个容器内运行的,目前边缘计算还不够成熟,以服务器为数据源和计算存储中心的 C/S 架构仍是未来一段时间的主流,所以接口相对于前端的重要性是不言而喻的(插一句,往后想想,与设备的连接接口以后会不会成为前端的新方向呢?这就成了边缘计算)。而对于 HTTP 请求而言,RESTful 是曾经统治一时的事实标准,非常 CRUD,但也非常不灵活。

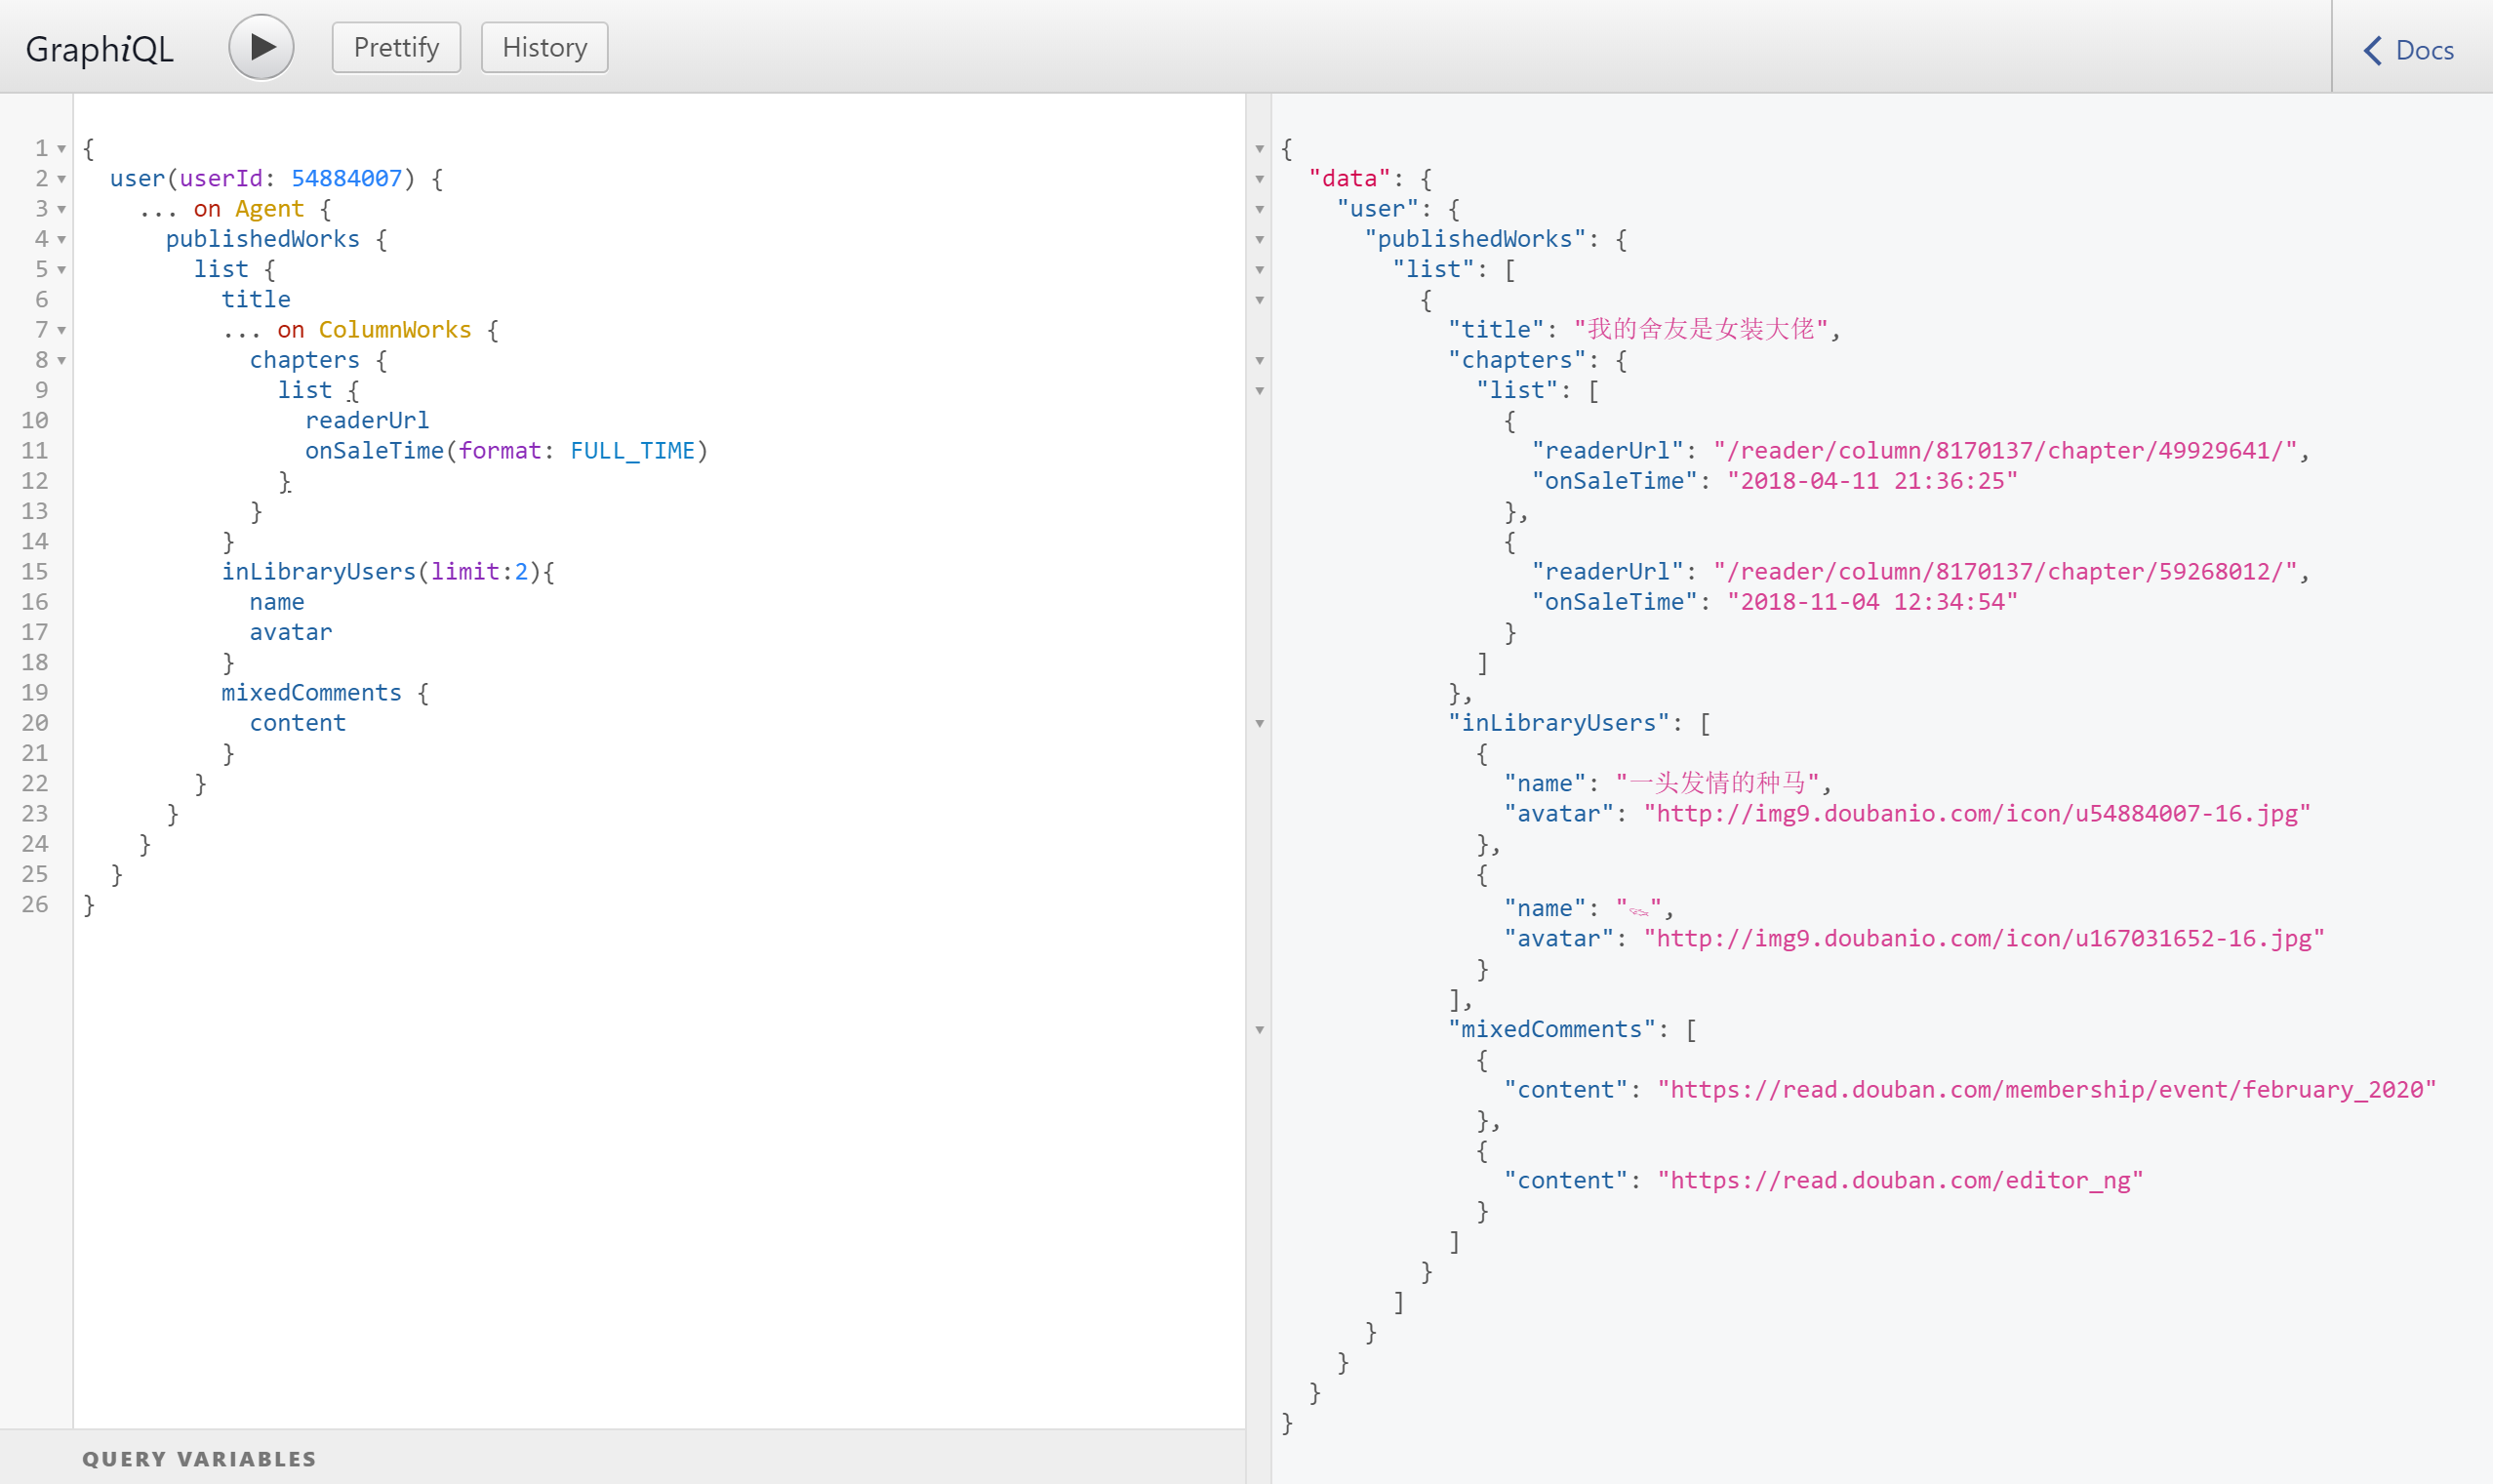
我们需要的是一种组织更加灵活、分层结构、高度复用、最好实现“自文档”的接口,这就是 GraphQL。虽然它也存在嵌套查询时会拖慢数据库,参数传递不清晰等毛病,但瑕不掩瑜,它确实是目前前端对于结构化数据查询最好的方式,更为出众的是它支持自定义返回字段,不多不少刚刚好是前端想要的那些,这简直太香了。

示例查询,用户 -> 作品 -> 评论/收藏用户/章节列表 -> 自定义格式上架时间

如果不考虑性能和异步并发,这些已经足以一个前端掌控 95% 的开发任务了,但往往那 5% 的事儿占据了 95% 的开发时间,后面会写写对于 Web Assembly 和 Reactive Programming 的理解,长远来看,当前围绕 html 进行的框架或者语言升级将告一段落,往后会转入多语言及范式涌入 web 开发领域碰撞并融合,浏览器正式成为继 iOS 和 Android 之后的第三大移动操作平台,更为可贵的是 web 的普适性使它几乎没有什么前置使用成本。